Un vieux PC sous Windows 98, un processeur d’un autre âge et 128 Mo de mémoire : au Royaume-Uni, des chercheurs prouvent que l’IA n’a pas forcément besoin d’un supercalculateur.
Alors que les investissements se chiffrent en milliards pour entraîner les derniers modèles d’intelligence artificielle, une équipe liée à l’Université d’Oxford, au Royaume-Uni, vient de montrer qu’un ordinateur datant de 1998 peut encore faire tourner une IA. Une expérience racontée par le site spécialisé Computerbase, qui bouscule l’idée selon laquelle seuls les data centers truffés de cartes graphiques récentes seraient capables de générer du texte façon ChatGPT.
Un Pentium II, 128 Mo de RAM et un modèle minimaliste
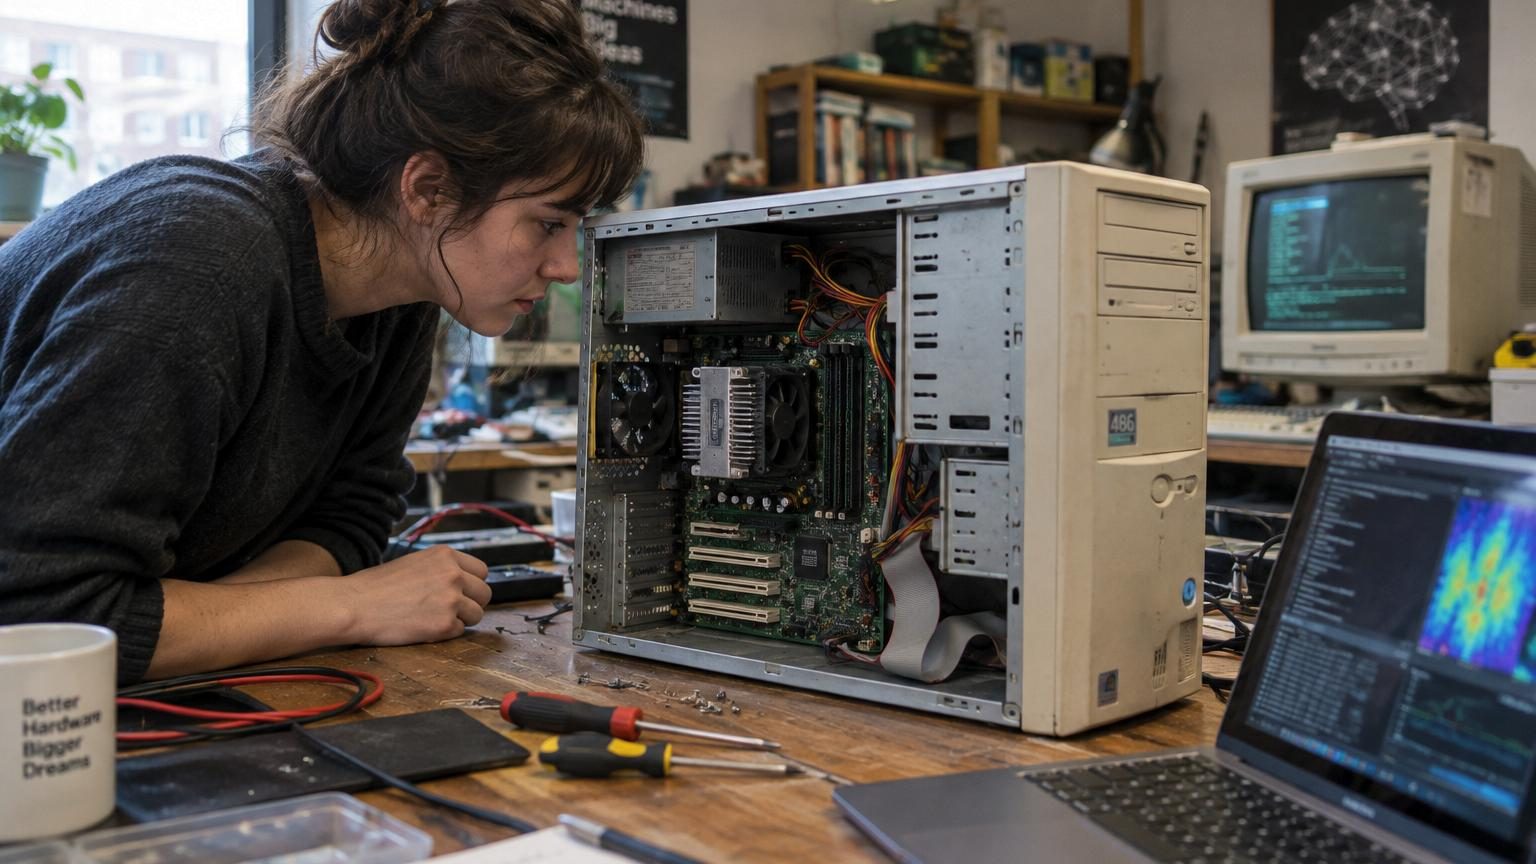
L’initiative vient d’EXO Labs, une organisation fondée par des chercheurs de l’Université d’Oxford. Dans une vidéo publiée sur le réseau social X, l’équipe fait tourner un modèle de langage sur une machine qui, à l’époque, servait surtout à jouer à Age of Empires ou à lancer Encarta.
Le PC utilisé embarque un processeur Pentium II cadencé à 350 MHz, accompagné d’à peine 128 Mo de mémoire vive, le tout sous Windows 98.
Sur cette configuration, EXO Labs fait tourner un petit modèle basé sur le code open source LLama2.c. Il ne s’agit évidemment pas d’un concurrent de GPT-4, mais d’un modèle extrêmement allégé de 260 000 paramètres. L’objectif n’est pas de battre des records de performance, mais de voir jusqu’où l’on peut descendre en matière de puissance de calcul.
Résultat : face à une requête simple, le PC de 1998 génère du texte pratiquement en temps réel. Les chercheurs mesurent une vitesse d’environ 39,31 tokens par seconde, soit plusieurs dizaines d’unités de texte traitées chaque seconde. Pour ce type de machine, c’est spectaculaire.
Les mêmes scientifiques estiment qu’un modèle de l’ordre du milliard de paramètres, sur ce matériel, tomberait à seulement 0,0093 token par seconde. Autrement dit, la machine mettrait plus d’une minute à produire une seule dizaine de mots, ce qui rendrait l’outil inutilisable au quotidien.
Des histoires absurdes, mais une syntaxe étonnamment cohérente
La démonstration ne vaut pas seulement pour les chiffres. EXO Labs a partagé un extrait de texte généré par ce Pentium II. Le résultat est loin d’un roman primé, mais la structure des phrases reste globalement compréhensible et grammaticalement correcte, malgré quelques absurdités.
Le modèle fait dialoguer des personnages comme « Sleepy Joe » et « Spot », enchaîne des actions étranges, mais conserve une certaine logique de phrases, avec des dialogues, des verbes conjugués et une narration continue.
On obtient un récit incohérent sur le fond, parsemé de répétitions et d’éléments surréalistes, mais la machine parvient à maintenir une continuité et une syntaxe correcte. Pour une IA tournant sur 128 Mo de RAM, c’est un signal fort : le langage artificiel n’exige pas forcément des dizaines de gigaoctets de mémoire pour générer une réponse formée.
Les chercheurs montrent ainsi que, bien en dessous des modèles géants actuels, des architectures minuscules restent capables de produire un texte lisible. Le prix à payer se situe surtout dans la qualité du contenu et la richesse des réponses, très limitées par la taille du modèle.
Quand l’optimisation logicielle compense la faiblesse du matériel
Cette expérience met surtout en lumière le rôle central de l’optimisation logicielle. EXO Labs ne change pas le processeur, ne monte pas la RAM, ne remplace pas le système d’exploitation par une version moderne ultra légère.
Le modèle est drastiquement réduit en nombre de paramètres.
Le code est adapté pour tourner sur une architecture ancienne.
Les calculs sont optimisés afin de limiter l’empreinte en mémoire.
Dans l’univers de l’IA actuelle, où Nvidia commercialise ses puces Blackwell B200 entre 30 000 et 40 000 dollars l’unité selon Computerbase, cette démonstration rappelle qu’il existe une autre voie : faire mieux avec moins, en retravaillant le logiciel plutôt qu’en augmentant sans cesse la puissance brute.
Un modèle minuscule, bien optimisé, peut suffire pour des tâches simples et tourner sur du matériel considéré comme obsolète depuis plus de vingt ans.
Pour des usages basiques – générer une phrase courte, proposer un texte très simple, répondre à des commandes élémentaires –, ces petits modèles peuvent déjà rendre des services, avec une consommation énergétique ridicule comparée aux énormes serveurs actuels.
Vers une IA vraiment accessible à tous ?
EXO Labs ne se contente pas de la performance « nostalgie » destinée aux passionnés de rétro-informatique. L’organisation affiche un objectif clair : démocratiser l’accès à l’intelligence artificielle, notamment dans les contextes où l’électricité, les connexions internet rapides ou le budget matériel manquent.
En rendant possible l’exécution locale de modèles légers sur des machines modestes, plusieurs perspectives s’ouvrent :
équiper des écoles ou associations dans des pays ou régions à faibles moyens informatiques ;
ajouter des fonctions « intelligentes » à de petits appareils électroniques sans gonfler leur coût ;
limiter la dépendance à des serveurs distants, pour des raisons de souveraineté ou de confidentialité ;
réduire l’empreinte énergétique des usages les plus basiques de l’IA.
L’enjeu n’est pas de remplacer les grands modèles de type GPT-4 pour la recherche ou l’analyse avancée, mais de montrer qu’une IA « du quotidien », très allégée, peut exister sur du matériel largement accessible, voire déjà disponible dans les placards d’entreprises ou d’administrations.
Ce que cela change pour un utilisateur français
Pour un lecteur en France, cette expérience menée au Royaume-Uni illustre un point clé : toutes les applications d’IA n’ont pas besoin d’être hébergées sur des serveurs externes appartenant à des géants américains. Dans certains cas, un modèle léger, exécuté directement sur un PC, une tablette ou un boîtier spécialisé, peut suffire.
Les fabricants de smartphones, d’ordinateurs ou d’objets connectés commencent déjà à intégrer des IA locales, avec des modèles embarqués dans l’appareil lui-même. L’expérience d’EXO Labs va dans le même sens, mais pousse le concept à l’extrême : si un Pentium II s’en sort, un PC portable d’entrée de gamme vendu aujourd’hui en France peut largement faire tourner des IA compactes.
Pour des tâches simples – résumé très court, corrections basiques, génération de texte rudimentaire –, un modèle miniature peut tourner sans connexion constante à un cloud distant.
En France, cette approche intéresse particulièrement les secteurs où la confidentialité est sensible : santé, justice, administrations, entreprises manipulant des données stratégiques. Plutôt que d’envoyer systématiquement ces informations vers des serveurs extérieurs, des solutions locales, même limitées, peuvent traiter une partie du travail.
Comprendre quelques notions techniques : paramètres, tokens et mémoire
Le terme « paramètres » désigne les valeurs internes d’un modèle d’IA, apprises lors de son entraînement. Un modèle géant peut en compter des dizaines, voire des centaines de milliards. Celui utilisé par EXO Labs n’en contient que 260 000, soit un nombre minuscule à l’échelle de l’IA moderne. Cette petite taille explique qu’il puisse tenir dans 128 Mo de RAM.
Les « tokens » sont, eux, des unités de texte manipulées par l’IA. Un token correspond à un mot entier ou à une partie de mot, selon la langue et le découpage choisi. La vitesse annoncée de 39,31 tokens par seconde signifie que le modèle produit ou traite environ quelques mots chaque seconde, ce qui suffit pour afficher un texte qui « défile » de façon fluide à l’écran.
La mémoire vive (RAM), enfin, sert à stocker les données temporaires nécessaires à l’exécution du modèle : paramètres chargés, calculs intermédiaires, historique de la conversation. Plus le modèle est gros, plus la RAM doit être importante. L’exploit d’EXO Labs consiste justement à faire tenir tout cela dans 128 Mo, alors qu’un PC moyen aujourd’hui embarque souvent des dizaines de gigaoctets.
Des usages concrets possibles pour des modèles ultra légers
Un modèle aussi compact n’assurera pas une rédaction fluide d’e-mails complexes ni la génération de code avancé. En revanche, ce type d’IA allégée peut viser plusieurs usages concrets :
assistance simple à la saisie de texte sur des appareils peu puissants ;
petits assistants vocaux embarqués dans des objets domestiques ;
outils pédagogiques basiques dans des écoles équipées de vieux parcs informatiques ;
systèmes d’aide contextuelle sur des logiciels métiers anciens, sans refonte totale.
En combinant ce genre de modèle à un matériel récent très économe, comme certains micro-ordinateurs, on peut imaginer des bornes d’information locales, des dispositifs d’assistance hors ligne ou des outils dédiés à des environnements isolés (sites industriels éloignés, navires, zones sans haut débit).
Cette expérience menée par EXO Labs, rapportée par Computerbase, agit comme un rappel : si l’intelligence artificielle spectaculaire repose sur des fermes de serveurs ultra puissants, une IA modeste mais utile peut aussi naître d’un simple Pentium II, à condition d’accepter des modèles plus petits, des tâches ciblées et un travail très poussé d’optimisation logicielle.
Lecture rapide : rédactrice en chef d’Eurotel, ancienne de l’hôtellerie, spécialiste des hôtels de caractère et des city-trips.
Hélène Vasseur a passé près de quinze ans dans l’hôtellerie avant de se consacrer à l’écriture. De la réception d’un palace lyonnais à la direction d’une maison d’hôtes, elle a appris à lire un hôtel de l’intérieur : ce qui fait une vraie adresse, et ce qui relève du décor.
Rédactrice en chef d’Eurotel, elle coordonne la ligne éditoriale et arpente l’Europe à la recherche d’hôtels de caractère et de destinations à raconter autrement. Sa conviction : on voyage mieux quand on comprend les lieux, pas seulement quand on les coche. Elle garde un faible pour les vieilles villes d’Europe centrale et les petits-déjeuners qui s’éternisent.
Quel modèle d'IA EXO Labs a-t-elle utilisé sur le Pentium II de 1998 ?
L'équipe a utilisé un petit modèle basé sur le code open source LLama2.c, extrêmement allégé avec seulement 260 000 paramètres, bien loin des milliards de paramètres des modèles géants actuels comme GPT-4.
Pourquoi les chercheurs ont-ils fait cette expérience sur du matériel aussi ancien ?
L'objectif n'était pas de battre des records de performance, mais de montrer jusqu'où on pouvait descendre en matière de puissance de calcul et de démocratiser l'accès à l'IA dans les contextes où l'électricité, internet ou le budget matériel manquent.
Un Pentium II pourrait-il faire tourner un modèle de un milliard de paramètres ?
Non, un tel modèle sur cette machine tournerait à seulement 0,0093 token par seconde, ce qui signifie que la machine mettrait plus d'une minute à produire une seule dizaine de mots, rendant l'outil inutilisable.
Quels sont les bénéfices pratiques de l'IA locale sur du matériel peu puissant ?
Cela permet d'équiper des écoles ou associations à faibles moyens, d'ajouter des fonctions intelligentes à de petits appareils sans gonfler leur coût, de réduire la dépendance à des serveurs distants pour des raisons de confidentialité, et de limiter l'empreinte énergétique.
Comment les fabricants de smartphones utilisent-ils ces enseignements ?
Les fabricants commencent déjà à intégrer des IA locales avec des modèles embarqués directement dans les appareils, une tendance que l'expérience d'EXO Labs illustre en poussant le concept à l'extrême.