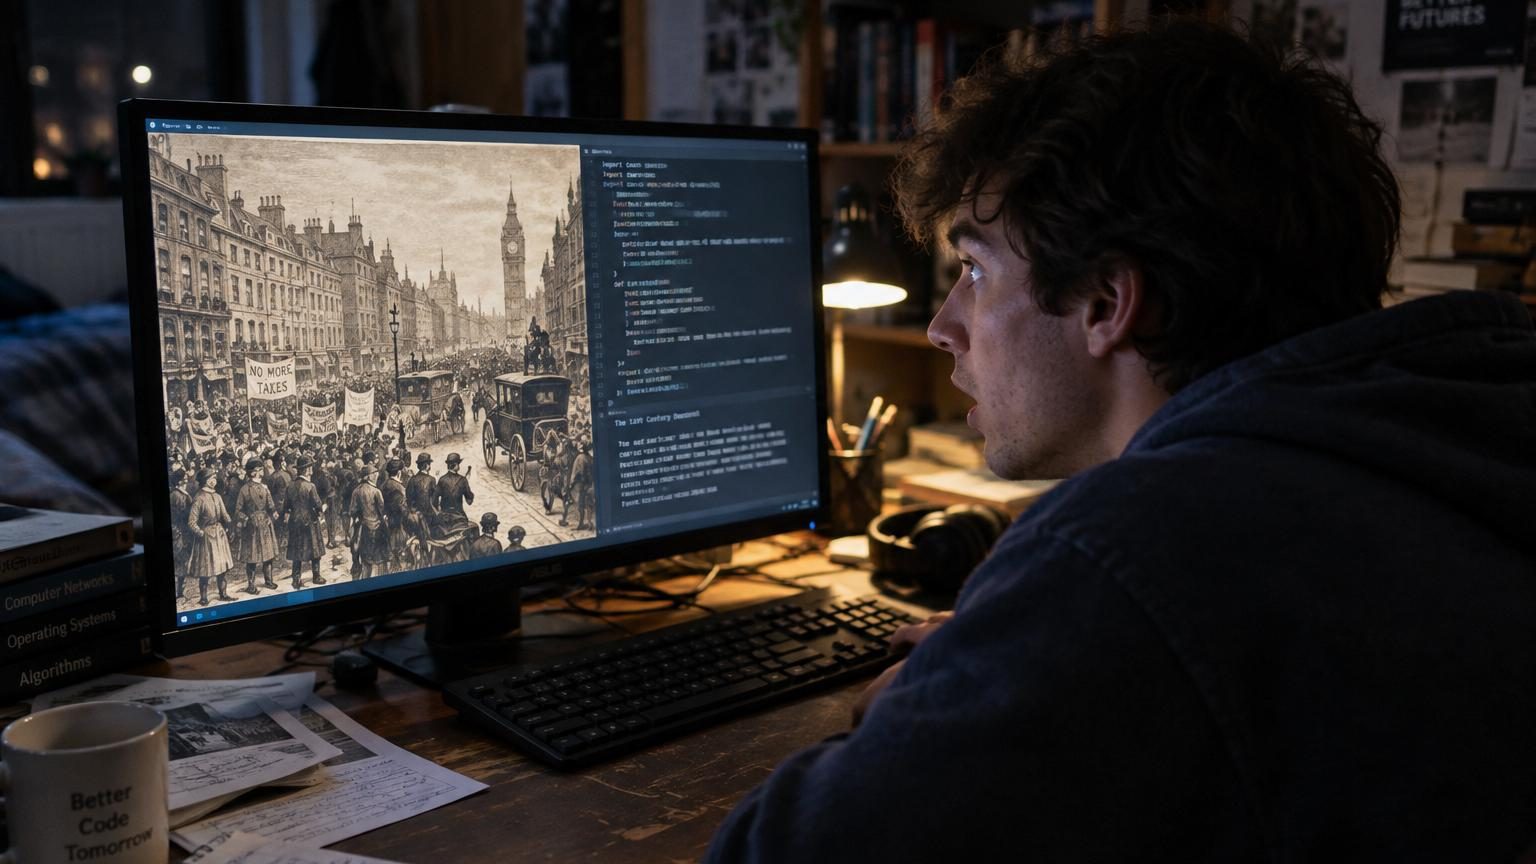
Un étudiant américain a créé une IA nourrie exclusivement d’écrits londoniens du XIXe siècle. Elle lui a décrit une agitation sociale bien réelle en 1834, qu’il ignorait totalement.
En travaillant sur un modèle d’intelligence artificielle parlant comme un Londonien de l’époque victorienne, un étudiant en informatique a été pris de court par sa propre création. Comme le raconte le site technologique Ars Technica, son IA a fait ressurgir un épisode historique précis de 1834 en Angleterre, que le développeur n’avait ni mentionné ni même en tête.
Un projet « pour le plaisir » qui tourne à la leçon d’histoire
Derrière cette expérience se trouve Hayk Grigorian, étudiant en informatique au Muhlenberg College, en Pennsylvanie (États-Unis), et développeur amateur de modèles de langage. Depuis un mois, il s’amuse à bâtir une IA baptisée TimeCapsuleLLM, censée écrire comme un auteur londonien de la première moitié du XIXe siècle.
Pour y parvenir, il a choisi une règle stricte : n’utiliser que des textes publiés à Londres entre 1800 et 1875. Au menu, selon son récit relayé par Ars Technica : plus de 7 000 livres, journaux, documents juridiques et autres imprimés, soit environ 6,25 Go de données, entièrement issues de cette période. Aucune trace de vocabulaire contemporain dans le corpus, ni de faits postérieurs à l’époque victorienne.
Son objectif n’est pas de construire un rival à ChatGPT, mais de capturer une « voix » authentiquement victorienne, avec son style ampoulé, ses références bibliques omniprésentes et sa rhétorique foisonnante.
TimeCapsuleLLM se veut une machine à remonter le temps linguistique : une IA qui ne « fait pas semblant » d’être ancienne, mais qui n’a été nourrie que d’écrits anciens.
Une simple phrase de départ, et l’IA bascule en 1834
L’épisode qui a intrigué son créateur part d’un test très basique. Hayk Grigorian demande à son modèle de continuer la phrase suivante, rédigée dans un style d’époque : « It was the year of our Lord 1834 » (« C’était l’an de grâce 1834 »).
TimeCapsuleLLM, entraîné à prolonger n’importe quel début de texte dans le style victorien, complète alors spontanément le passage. Il évoque des rues de Londres remplies de « protestations et de pétitions », parle de « difficultés » liées à la loi et mentionne un personnage bien réel de la politique britannique : Lord Palmerston.
Sur le moment, le développeur pense d’abord à une sorte de coïncidence littéraire. Puis il commence à se demander si ces allusions correspondent à un épisode historique précis. Il se tourne vers un moteur de recherche pour vérifier.
« J’étais curieux de voir si une manifestation avait réellement eu lieu à Londres en 1834 et elle a vraiment eu lieu », écrit-il sur Reddit. En cherchant, il découvre aussi que les décisions de Lord Palmerston ont effectivement joué un rôle dans des mouvements de protestation à cette époque tourmentée.
Une référence exacte aux troubles provoqués par la loi de 1834
Ars Technica rappelle que l’année 1834 est marquée en Angleterre par d’importantes tensions sociales, notamment liées à la Poor Law Amendment Act 1834, une réforme de l’assistance aux pauvres. Cette loi réorganise l’aide publique, jugée jusqu’alors trop généreuse par certains responsables politiques, en renforçant la mise au travail forcé au sein de maisons de travail très dures.
Cette réforme provoque une vague de mécontentement dans la population, sur fond de débats parlementaires houleux. La période voit aussi plusieurs mobilisations et pétitions, tandis que des figures politiques, dont Henry John Temple, plus connu sous le nom de Lord Palmerston, occupent des fonctions de premier plan au gouvernement britannique. À ce moment-là, Palmerston est secrétaire aux Affaires étrangères, avant de devenir plus tard Premier ministre.
Le texte généré par TimeCapsuleLLM ne reconstitue pas en détail un événement unique, mais il assemble plusieurs éléments justes : l’année, la ville de Londres, un climat de protestation et la présence d’un responsable politique qui a effectivement pesé sur les événements de l’époque.
L’IA n’a jamais reçu d’instruction directe sur « les manifestations de 1834 », mais elle a relié un millésime, un lieu et une figure politique à une situation historique réelle à partir d’écrits épars.
Un modèle minuscule qui surprend par sa cohérence historique
Pour les spécialistes interrogés par Ars Technica, ce type de résultat reste logique : les modèles de langage apprennent à recombiner les informations présentes dans leurs données d’entraînement, sans « comprendre » comme un historien. Chez les grands modèles, ce genre de reconstitution se produit régulièrement.
Ce qui intrigue ici, c’est que tout vient d’un modèle relativement petit, entraîné sur des moyens limités. Hayk Grigorian a utilisé des architectures de « small language models » inspirées de nanoGPT et de Phi 1.5, deux projets bien plus compacts que les énormes systèmes commerciaux. Il a progressivement fait évoluer son IA en plusieurs versions :
- Version 0 : entraînée sur 187 Mo seulement, elle produit un pseudo-anglais victorien largement incompréhensible.
- Version 0.5 : le style devient grammaticalement correct, mais les faits historiques restent fantaisistes.
- Version actuelle : un modèle de 700 millions de paramètres, entraîné sur une carte graphique A100 louée, commence à « se souvenir » d’événements et de personnages réels.
Sur GitHub, le développeur explique que les premiers modèles parvenaient déjà à imiter le ton du XIXe siècle, mais « hallucinaient » systématiquement les faits, inventant événements, dates et noms. Avec l’augmentation progressive de la quantité et de la qualité des données, il observe une nette baisse de ces affabulations.
« Les versions précédentes pouvaient imiter le style du XIXe siècle mais inventaient tout le reste, écrit-il. Cette version montre que le modèle commence à se souvenir de choses présentes dans le jeu de données. »
Un entraînement « sélectif dans le temps » pour éviter le présent
Pour garantir le caractère strictement victorien de sa machine, Hayk Grigorian a mis en place une méthode qu’il appelle « Selective Temporal Training » (STT), un entraînement sélectif dans le temps. Le principe : n’injecter dans le modèle aucun texte moderne, ni même aucun vocabulaire postérieur à la période visée.
Il utilise pour cela un « tokenizer » personnalisé, un outil qui découpe les mots en unités plus simples pour que l’IA puisse les traiter. Ce tokenizer est conçu pour ignorer totalement le lexique contemporain.
Cette approche se distingue de la stratégie courante qui consiste à « affiner » un grand modèle généraliste déjà formé, comme GPT-2, avec des textes d’époque. « Si j’affine un modèle comme GPT-2, il est déjà pré-entraîné et cette information ne disparaîtra pas », explique-t-il sur GitHub. À ses yeux, seule une formation depuis zéro, sur un corpus strictement daté, permet d’obtenir une IA qui « est » d’époque plutôt que de « jouer » un rôle.
Un outil potentiel pour les historiens et les sciences humaines
Pour les chercheurs en histoire et en humanités numériques, ces modèles appelés « Historical Large Language Models » (HLLM) ouvrent un nouveau champ d’expérimentation. D’autres projets cités par Ars Technica existent déjà, comme MonadGPT, entraîné sur 11 000 textes allant de 1400 à 1700, ou XunziALLM, spécialisé dans la poésie chinoise ancienne.
Ces IA ne remplacent évidemment pas le travail des historiens. Elles restent sujettes aux confabulations, ces réponses inventées mais plausibles qui posent aujourd’hui problème dans nombre d’outils conversationnels. En revanche, elles peuvent servir de laboratoire linguistique :
- pour étudier un style, une syntaxe ou un vocabulaire d’époque en situation d’usage simulée ;
- pour proposer aux étudiants une interaction avec une « voix » du passé, tout en restant conscient des limites factuelles ;
- pour repérer des tournures oubliées et des constructions typiques d’une ville, d’une classe sociale ou d’un courant religieux à une période donnée.
Hayk Grigorian dit vouloir aller plus loin et imaginer des modèles spécialisés sur d’autres villes, y compris en Chine, en Russie ou en Inde. Il a ouvertement invité d’éventuels collaborateurs à le rejoindre, et met en libre accès son code, les poids de ses modèles et la documentation de son travail.
En France, des projets similaires autour des textes anciens
En France, plusieurs laboratoires et institutions patrimoniales s’intéressent aussi à l’utilisation de l’IA sur des corpus historiques. Des bibliothèques numériques comme Gallica, de la Bibliothèque nationale de France, servent de base à des modèles chargés de transcrire, indexer et analyser des journaux anciens ou des ouvrages numérisés.
Certains projets académiques testent déjà des modèles de langage adaptés au français du XIXe siècle, en partant de journaux, romans ou archives administratives de l’époque. Leur but : faciliter la recherche de termes anciens, relier des personnages cités dans des documents ou identifier des thématiques récurrentes dans la presse d’un siècle donné. Ces modèles restent généralement à usage interne ou académique, et sont manipulés par des historiens ou linguistes qui en connaissent les biais.
Qu’il s’agisse de Londres ou de Paris, l’idée reste la même : utiliser l’IA comme loupe sur des masses d’archives, tout en laissant aux chercheurs le soin d’interpréter.
Pour un lecteur français, l’apport principal de ces approches réside dans la possibilité de mieux comprendre un contexte historique précis, sans passer soi-même des années à dépouiller des milliers de pages. Mais l’interprétation, la critique des sources et la mise en perspective restent du ressort des spécialistes humains.
Une « factcident » plutôt qu’une hallucination
L’anecdote relatée par Ars Technica a inspiré un néologisme à l’auteur de l’article : à l’inverse des hallucinations, cette IA vient de produire par accident une information exacte. Une sorte de « fait-accident », ou « factcident », selon le mot utilisé en anglais.
Cette scène rappelle aussi un principe clé : un modèle de langage ne « sait » rien au sens humain. Il exploite des régularités statistiques dans les textes. Lorsque ceux-ci sont nombreux, cohérents et bien circonscrits dans le temps, l’illusion d’un savoir historique peut devenir frappante. L’exemple de TimeCapsuleLLM montre qu’avec un corpus limité mais soigneusement choisi, un simple test peut se transformer en petite leçon d’histoire, y compris pour celui qui a conçu la machine.