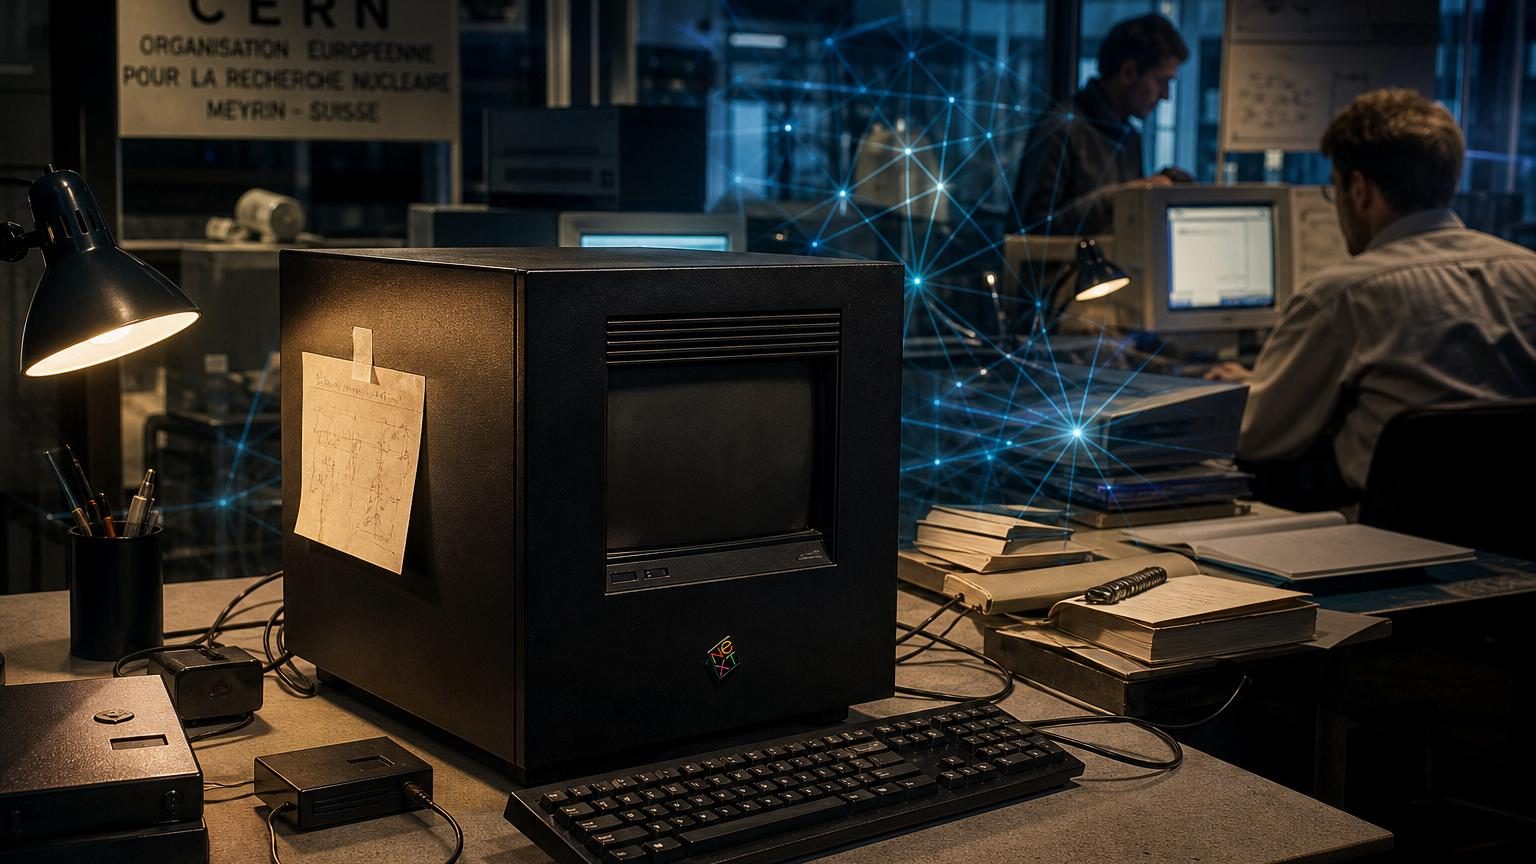
Dans les sous-sols du CERN, près de Genève, une petite machine noire rappelle qu’Internet n’a pas toujours semblé évident.
Elle ne ressemble ni à une salle informatique moderne ni à un équipement de recherche spectaculaire. Pourtant, ce cube noir conservé à Meyrin occupe une place à part dans l’histoire contemporaine. Sur son boîtier, une consigne manuscrite a longtemps suffi à protéger une machine devenue, en 1990, le premier serveur du Web.
Un cube discret à l’origine d’un immense réseau
À la fin des années 1980, les scientifiques du CERN échangent une quantité croissante de documents, de notes et de données. Les équipes travaillent dans plusieurs pays, changent régulièrement de laboratoire et utilisent des systèmes informatiques souvent incompatibles. Retrouver une information relève parfois du parcours d’obstacles.
C’est dans ce contexte que Tim Berners-Lee, ingénieur britannique employé par le centre de recherche, imagine un système simple : relier des documents entre eux afin qu’un chercheur puisse passer de l’un à l’autre en quelques clics. L’idée repose sur des liens hypertextes, ces renvois qui permettent aujourd’hui d’ouvrir une autre page sans quitter son écran.
Pour concrétiser ce projet, il s’appuie sur un ordinateur conçu par NeXT, l’entreprise créée par Steve Jobs après son départ d’Apple en 1985. L’appareil, baptisé NeXT Cube, affiche une silhouette singulière : un boîtier sombre, compact, presque austère, loin des ordinateurs personnels colorés ou des serveurs imposants que l’on connaît désormais.
Ce cube noir a accueilli à la fois le premier serveur du Web et les premiers outils permettant de consulter et de modifier des pages reliées entre elles.
Durant l’année 1990, Tim Berners-Lee y développe son projet, alors destiné d’abord aux chercheurs. Il crée un logiciel capable de lire des pages et de les éditer, une fonction rare à l’époque. L’utilisateur n’était pas seulement lecteur : il pouvait aussi participer à la construction des contenus.
Une simple note pour éviter une coupure fatale
Sur le côté de la machine, une note écrite à la main demandait de ne jamais couper son alimentation. La formule, très directe, n’avait rien d’un objet décoratif. Elle signalait aux personnes présentes dans le laboratoire que l’ordinateur remplissait une mission précise : maintenir le serveur disponible.
À cette période, l’informatique ne dispose pas des protections habituelles des grandes plateformes actuelles. Il n’existe ni immense réseau de secours, ni duplication automatique sur des centres de données situés à l’autre bout du continent. Si quelqu’un débranchait l’appareil, les premières pages du Web devenaient inaccessibles.
Cette fragilité explique la force symbolique de l’étiquette. Une révolution numérique mondiale reposait alors sur un matériel unique et sur la vigilance quotidienne des chercheurs et techniciens qui passaient à proximité.
- Un seul ordinateur hébergeait les premières ressources accessibles sur le Web.
- Une coupure électrique pouvait interrompre le service.
- Les documents étaient initialement pensés pour les besoins internes de la recherche.
- La consigne manuscrite faisait office d’alerte immédiate pour éviter une erreur humaine.
Le Web avant les moteurs de recherche
Les premiers temps du Web n’ont rien à voir avec les usages actuels. Il n’y a ni réseaux sociaux, ni vidéos en continu, ni moteur de recherche performant. Les utilisateurs connaissent généralement l’adresse du document qu’ils veulent consulter ou reçoivent un lien de la part d’un collègue.
Le système mis au point au CERN repose sur trois idées devenues familières : une adresse pour localiser une ressource, un protocole pour demander une page à un serveur et un langage permettant de structurer le contenu affiché. Ces fondations ont évolué, mais elles organisent encore une grande partie de la navigation en ligne.
Le premier navigateur conçu par Tim Berners-Lee permettait déjà d’ouvrir des documents reliés par des liens. Il pouvait aussi servir à créer ou modifier des pages. Cette double fonction reflétait une ambition précise : faire du Web un espace de partage, et pas seulement une vitrine où quelques acteurs publient pour des millions de lecteurs.
Le choix qui a empêché l’appropriation du Web
Le projet reste d’abord confidentiel. Puis, en août 1991, Tim Berners-Lee le présente à une communauté d’informaticiens sur les espaces de discussion de l’époque. Des développeurs commencent alors à s’y intéresser et créent leurs propres outils pour accéder aux premières pages.
Le moment décisif intervient le 30 avril 1993. Le CERN rend la technologie accessible sans redevance et sans brevet bloquant. Cette décision ouvre la voie à une adoption très rapide par les universités, les entreprises, les administrations puis le grand public.
En renonçant à faire payer l’usage de son invention, le CERN a permis au Web de se diffuser comme une infrastructure commune plutôt que comme un produit fermé.
Ce choix a favorisé l’apparition de milliers de sites, de navigateurs concurrents et de services numériques. Il n’a pas empêché les grandes entreprises de bâtir ensuite des modèles économiques autour de la publicité, de la vente en ligne ou des données. Il a surtout évité qu’un seul organisme contrôle les règles d’accès à cette technologie naissante.
La machine est désormais visible à Meyrin
Le NeXT Cube historique n’est plus relié au réseau. Il est exposé au musée Microcosm, sur le site du CERN à Meyrin, dans le canton de Genève. Les visiteurs peuvent observer son écran, son clavier et plusieurs documents liés à la naissance du Web.
Parmi eux figure une copie de la proposition rédigée par Tim Berners-Lee pour résoudre les difficultés de gestion de l’information au sein du laboratoire. Le document ne promettait pas de bouleverser la vie quotidienne de milliards de personnes. Il répondait à un problème concret de chercheurs qui avaient besoin de mieux partager leurs connaissances.
Le contraste est frappant. Cette machine, modeste face aux infrastructures numériques actuelles, a participé à une transformation qui touche désormais le travail, l’école, la santé, les loisirs, l’information et les relations personnelles.
Pourquoi un serveur ne doit pas être confondu avec un simple ordinateur
Un serveur est un ordinateur qui fournit un service à d’autres appareils connectés. Dans le cas du premier serveur du Web, il stockait des pages et les envoyait aux utilisateurs qui en faisaient la demande. Aujourd’hui, un même service peut s’appuyer sur des centaines de machines réparties dans plusieurs pays.
La différence est majeure : les plateformes modernes cherchent à éviter toute interruption grâce à des copies de secours et à des systèmes capables de prendre le relais. En 1990, le cube de Tim Berners-Lee incarnait à lui seul cette fonction. La note collée sur son flanc n’était donc pas une anecdote amusante : elle protégeait un point de départ fragile.
Trente-six ans plus tard, l’objet rappelle aussi une réalité moins visible : les innovations qui transforment durablement la société naissent parfois d’un besoin local, d’un outil imparfait et d’une consigne griffonnée à la hâte sur un morceau de papier.